
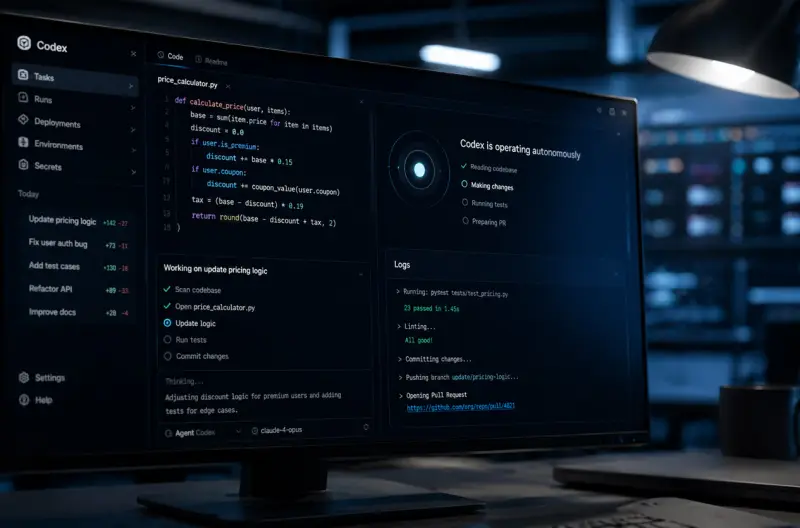
Mehr Ausdauer beim Refactoring: Was GPT-5.1-Codex-Max für die Softwaremodernisierung im Mittelstand bedeutet
Das neue OpenAI-Modell verspricht 24-Stunden-Coding-Sessions ohne Gedächtnislücken und setzt erstmals konsequent auf Windows.
Agenten, die Code nicht nur ergänzen, sondern über viele Stunden hinweg autonom prüfen, testen und verbessern, rücken mit GPT-5.1-Codex-Max ein gutes Stück näher. OpenAI hat sein jüngstes Spezialmodell mit einer Technologie ausgestattet, die das berüchtigte „Kontextlimit“ elegant umgeht. Für mittelständische Unternehmen, die komplexe Altanwendungen modernisieren oder große Neuentwicklungen stemmen, könnte das den entscheidenden Effizienzschub bringen. Ein Überblick über Funktionen, Kennzahlen und Einsatzszenarien sowie eine Einordnung, wo nach wie vor Vorsicht geboten ist.
Die nächste Stufe des „Agentic Coding“
Bislang verhielten sich Code-Generatoren ähnlich wie ein erfahrener Pair-Programmer: Sie vervollständigten Methoden, schlugen Optimierungen vor, verloren jedoch rasch den Überblick, sobald mehrere Hundert Zeilen Kontext zusammenkamen. Die Idee des Agentic Coding verfolgt einen anderen Ansatz: Das Modell agiert als eigenständiger Agent, der selbstständig Tests anlegt, Fehlermeldungen auswertet, Refactoring-Runden einleitet und dabei das übergeordnete Ziel im Blick behält. GPT-5.1-Codex-Max ist laut OpenAI das erste Mitglied der Familie, das diesen Arbeitsmodus über sehr lange Zeitfenster hinweg zuverlässig durchhält (openai.com).
Compaction – ein algorithmischer Notizblock
Herzstück der Innovation ist die sogenannte Compaction-Methode. Sprachmodelle besitzen naturgemäß einen „Kurzzeitspeicher“ – das Kontextfenster. Wird es zu voll, fällt der Beginn des Gesprächs hinten herunter, die KI vergisst Details oder „halluziniert“ Zusammenhänge. Compaction funktioniert wie ein algorithmischer Notizblock:
- Relevanzfilter: Irrelevante Passagen der Historie werden verworfen.
- Verdichtung: Kerninformationen werden in kompakte Repräsentationen überführt.
- Kontext-Re-Injection: Die verdichtete Historie bleibt im Arbeitsspeicher, sodass neue Eingaben wieder daran anknüpfen können.
ZDNet vergleicht das Vorgehen mit einem Gespräch, in dem man sich auf das Wesentliche fokussiert, wenn die Aufmerksamkeit nachlässt (zdnet.com). OpenAI spricht von mehr als 24 Stunden kontinuierlicher Arbeit ohne „roten Faden“-Verlust – ein Versprechen, das in realen Kundenprojekten erprobt werden will, aber eine deutliche Richtung vorgibt.
Effizienzgewinne in Zahlen
Längere Aufmerksamkeitsspannen sind nur dann ein Fortschritt, wenn sie nicht durch explodierende Rechenzeiten kompensiert werden müssen. In Benchmarks – etwa dem SWE-bench-Verified – verbrauchte GPT-5.1-Codex-Max rund 30 Prozent weniger „Thinking Tokens“ bei identischer Aufgabenstellung als sein Vorgänger. In einem öffentlich präsentierten Frontend-Szenario schrumpfte die Token-Gesamtzahl von 37 000 auf 27 000, ohne dass Funktionalität verloren ging.
Für IT-Verantwortliche bedeuten geringere Token-Mengen zweierlei:
- Kürzere Antwortzeiten in CI/CD-Pipelines, wenn die KI automatisiert Pull-Requests prüft.
- Direkte Senkung der Kosten, da die meisten Anbieter tokenbasiert abrechnen.
Die Benchmarks sind erste Indikatoren; erfahrungsgemäß zeigt sich der Effekt besonders stark bei repetitiven Wartungsaufgaben wie Regressionstest-Anpassungen oder Style-Linting in großen Monorepos.
Windows rückt in den Mittelpunkt
Eine kleine, aber strategisch bedeutsame Fußnote in der Produktankündigung: GPT-5.1-Codex-Max wurde explizit für Windows-Umgebungen trainiert. Historisch richteten sich viele KI-gestützte DevTools primär an Unix-Shells oder macOS-Setups. Für den deutschen Mittelstand, in dem Windows-Laptops dominieren, sinkt damit die Einstiegshürde erheblich.
Neben besserer CLI-Unterstützung betont OpenAI die Härtung der Sandbox: Schreibrechte bleiben auf das Arbeitsverzeichnis beschränkt, Netzwerkzugriffe sind per Default deaktiviert. Das ist relevant für Unternehmen, die KI-Assistenten erst nach einer strengen Risikoanalyse in produktiven Repositories zulassen.
Wo Spezialisierung Grenzen setzt
Kein Modell ist Allheilmittel. In kurzen, isolierten Terminal-Aufgaben zeigt sich ein Leistungsabfall: Im Terminal-Bench 2.0 erzielte Codex-Max 52,8 Prozent Genauigkeit gegenüber 58,1 Prozent seines Vorgängers. Offenbar erkauft sich die Langstrecken-Optimierung einen Teil der Präzision bei „One-Shot“-Kommandos.
Hinzu kommt das Staffelniveau „Reasoning“. Neben einer Standard- und einer „High“-Stufe bietet OpenAI nun „Extra High“, bei dem das Modell besonders lange über seine Antwort nachdenkt. Qualität steigt, Latenz ebenfalls – ein klassischer Trade-off, den Projektleiterinnen im Auge behalten sollten, wenn Continuous-Deployment-Zyklen knapp getaktet sind.
Praktische Einsatzszenarien im Mittelstand
- Legacy-Modernisierung: Viele ERP- oder MES-Systeme im Mittelstand entstanden vor über zehn Jahren. Das Durcharbeiten heterogener Codebasen in ABAP, C# und Java erfordert Ausdauer und Kontexttreue – beides Stärken von Codex-Max. 2. Test-Coverage-Erhöhung: Automatisiertes Schreiben und Anpassen von Integrationstests lässt sich nun über Nacht durchführen, ohne dass Test-Suiten fragmentieren.
- UI-Refactoring unter Windows: Frontend-Teams, die per PowerShell oder WSL entwickeln, profitieren von der neuen Plattform-Fokussierung.
- Dokumentations-Audit: Durch Compaction kann die KI über mehrere tausend Seiten Wiki-Einträge hinweg konsistente Architekturbeschreibungen ableiten.
In eigenen Projekten zeigt sich, dass die Hauptgewinne dort liegen, wo kontinuierliche Konversation mit demselben Modell entscheidend ist – beispielsweise bei Security-Reviews, die mehrere Iterationsschleifen umfassen.
Best Practices für einen sicheren Einstieg
- Klare Zielgrenzen definieren: Warum soll die KI arbeiten? „Refactor Modul A“ statt „Verbessere alles“.
- Compaction-Logs prüfen: OpenAI ermöglicht Einblick in die verdichteten Zwischenstände. So lässt sich nachvollziehen, ob wichtige Randbedingungen erhalten bleiben.
- Reasoning-Stufen adaptiv wählen: Für schnelle Pre-Commit-Checks genügt die Standardtiefe, bei komplexen Architekturentscheidungen lohnt der höhere Modus.
- Hybrid-Betrieb erwägen: Für kurzfristige Shell-Befehle kann ein schlankeres Modell weiterhin die bessere Wahl sein.
Gelingt diese Feinkalibrierung, entsteht ein produktives Miteinander aus menschlicher Expertise und maschineller Ausdauer.
Lizenz- und Verfügbarkeitsstatus
GPT-5.1-Codex-Max steht seit Mitte November 2025 allen zahlenden ChatGPT-Nutzergruppen (Plus, Pro, Team, Enterprise) zur Verfügung. Der Zugang erfolgt zunächst über die Codex-Oberfläche, eine API folgt laut Hersteller in Kürze. Unternehmen, die eigene Toolchains anbinden möchten, sollten dennoch jetzt mit Proof-of-Concepts beginnen, um Migrationspfade zu klären, sobald die Schnittstellen freigeschaltet sind.